Peut-on reconstruire une image à partir de huit nombres, puis retrouver des traits qui ont été effacés ? Un autoencodeur est un réseau entraîné à reproduire son entrée après l’avoir fait passer par un goulot de quelques nombres : la moitié qui comprime s’appelle l’encodeur, celle qui reconstruit le décodeur. Ce prototype de projet AP9 au choix prolonge les réseaux d’AP5. Nous le commençons ensemble en cours ; vous poursuivez l’implémentation et l’expérience à la maison. Les modalités de notation et l’échéance seront précisées avant le lancement en janvier ; les étapes ci-dessous ne sont pas un barème.
Téléchargez le squelette autoencodeur. Son README contient le sujet complet, les contrats, les indications Nx, les commandes et le dépannage. Les données, l’entraînement, les sauvegardes et les grilles SVG sont fournis. Aucun GPU ni connaissance HTML, CSS ou JavaScript n’est nécessaire. Le dépôt du cours IA n’est pas requis.
Voir les données avant de construire le modèle
Ouvrez le terminal dans le dossier extrait, avec Elixir installé avant AP6 :
mix deps.get
mix test --only fourni
mix ae.preview
La première commande télécharge Nx et ses dépendances, verrouillées dans
mix.lock. Les six tests fournis doivent passer. Ouvrez results/corpus.svg
dans VS Code. Les données sont 128 petites images de huit pixels par huit,
obtenues à partir de huit glyphes originaux placés à seize positions. Le projet
sépare 96 images d’apprentissage, 16 de validation et 16 de test avant toute
corruption ; aucune image identique n’appartient à deux partitions.
Les petits dessins sont produits localement, sans téléchargement de MNIST. Ils partagent une même famille de formes : votre expérience ne démontrera pas une réparation universelle d’images ni une reconnaissance d’écriture.
Traverser un goulot de quelques nombres
L’encodeur transforme les 64 pixels en un code latent de taille L. Le
décodeur tente de revenir aux pixels. L’ensemble des codes possibles s’appelle
l’espace latent : avec L = 8, chaque image devient un point d’un espace de
dimension 8. Dans le modèle de départ, L = 8 : nous allons voir quelles
informations passent dans ce goulot.
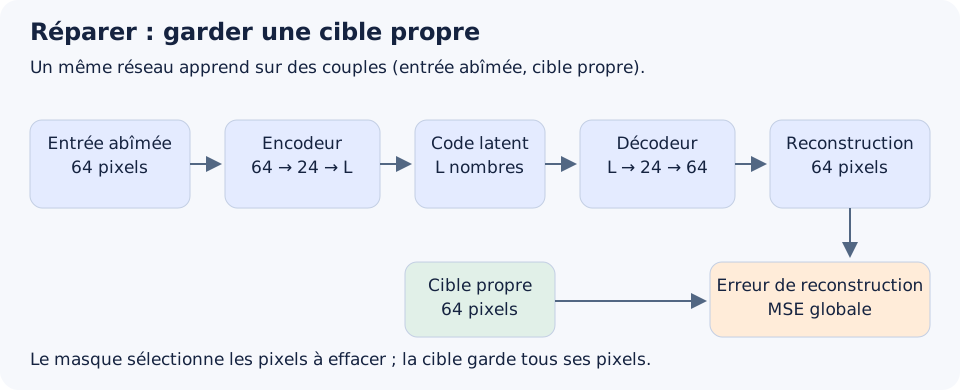
Le schéma se lit de gauche à droite : l’entrée abîmée traverse l’encodeur,
devient un code de L nombres, puis ressort du décodeur sous la forme de 64
pixels ; l’erreur compare cette reconstruction à la cible propre, qui n’est
jamais montrée au réseau. Vous écrivez cinq fonctions du socle :
| Fonction | Travail demandé |
|---|---|
encode/2 | Deux couches denses, avec une ReLU entre les deux ; {B,64} devient {B,L}. |
decode/2 | Deux couches denses, une ReLU puis une sigmoïde finale ; retour à {B,64}. |
corrupt/3 | Effacer les positions tirées et renvoyer leur masque, en conservant la cible propre. |
mse/2 | Mesurer l’erreur quadratique moyenne globale. |
masked_mse/3 | Mesurer cette erreur seulement aux positions masquées. |
La multiplication dense est fournie. Le réseau est écrit directement avec
Nx, en rendant visibles les matrices des couches utilisées avec Axon en AP5.
Le README rappelle les formes, les activations et le nombre de paramètres :
le modèle de départ en compte 3 576, que vous pouvez prédire avec I × O + O
par couche. Les fonctions utilisent defn ; le gradient et Adam restent fournis.
mix test --only modele
mix test --only corruption
mix test --only erreurs
mix test
mix test --include integration
Les tests pédagogiques échouent avec « À compléter » jusqu’à ce que vous ayez écrit les fonctions. Ajoutez des cas calculables à la main : lot d’une image, masque vide ou erreur globale différente de l’erreur masquée.
Réparer et comparer
L’entrée d’un autoencodeur de débruitage est abîmée, mais sa cible reste propre. Le code renouvelle les trous pendant l’apprentissage et garde une corruption fixe en validation. Le réseau reçoit seulement les pixels, pas le masque : un zéro peut être un fond intact ou un trait manquant.
mix ae.train ae --steps 25 --out results/essai
mix ae.train ae --steps 300 --noise 0.35 --out results/denoise-l8
mix ae.train ae --steps 300 --noise 0.35 --latent 2 --out results/denoise-l2
Les SVG montrent les originaux, les entrées abîmées et les reconstructions. Une courbe conserve les MSE de validation ; un CSV, les configurations et les versions permettent de refaire l’expérience. Un pas traite seize images. L’essai de préparation de 300 pas a pris environ huit secondes sur le CPU d’un portable Apple M3, hors compilation ; commencez par 25 pas sur votre poste.
Comparez votre réseau à deux références fournies : renvoyer l’entrée abîmée, ou dessiner systématiquement l’image moyenne de l’apprentissage. Mesurez l’erreur globale et celle des positions masquées. Lors de la préparation, le réseau améliorait l’erreur masquée tout en dégradant légèrement l’erreur globale : il restaurait des traits, mais en modifiait aussi d’autres qui étaient encore visibles. Une courbe qui descend ne suffit donc pas à conclure.
Choisissez une question expérimentale, par ex. l’effet de L, et gardez
les autres réglages fixes. L’option --noise 0.0 permet de commencer par
reconstruire des images intactes. L’interpolation entre deux codes est
également dessinée. Gardez la partition de test pour le modèle finalement
choisi, avec mix ae.evaluate ; le README donne la commande et la trame de
COMPTE-RENDU.md. Le dossier results/ est ignoré par Git : copiez les
expériences retenues dans rendu/.
Prolongement accompagné : un VAE
Un code interpolé entre deux images connues et un code tiré au hasard ne
posent pas le même problème. Avec le VAE (variational autoencoder), chaque
entrée ne donne plus un seul code, mais une moyenne mu et un log de variance
logvar. Le code est tiré au hasard dans cette distribution avant de passer
dans le décodeur : c’est en ce sens que l’espace latent devient probabiliste.
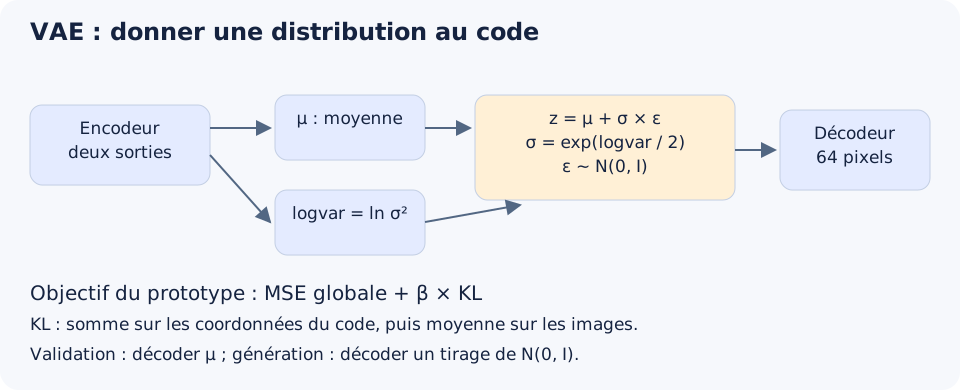
La seconde tête du réseau et la boucle sont fournies. Vous complétez deux
fonctions supplémentaires, avec formules et tests : la reparamétrisation
mu + exp(logvar / 2) * epsilon, puis la divergence KL vers une normale
standard, c-à-d. la pénalité qui rapproche chaque distribution de la
normale centrée réduite. Cette dernière somme les coordonnées latentes puis
moyenne le lot.
mix test --include vae
mix ae.train vae --steps 300 --beta 0.001 --out results/vae-b001
Comparez deux valeurs de beta, la reconstruction et les tirages de
samples.svg. Le prototype utilise MSE + beta * KL ; les conventions de
réduction et leurs conséquences sont expliquées. La validation décode la
moyenne mu, sans bruit : elle ne mesure pas exactement l’objectif
stochastique d’entraînement. Aucune génération de chiffres convaincants
n’est promise. Les formes floues ou mal définies font partie des résultats
à analyser.
Les articles de Vincent et al. et de Kingma et Welling donnent les mécanismes d’origine. Leur lecture est facultative ; le README permet de travailler seul. Pour toute question, vous pouvez me contacter par email avec la commande, l’erreur et l’exemple qui reproduit le souci.
Pour les curieux : le fascicule
Un petit fascicule d’approfondissement accompagne ce sujet : les idées derrière le projet, leur histoire, ce qu’elles deviennent dans les systèmes réels et quoi lire ensuite. C’est un cadeau de fin de cours ; rien n’y est à rendre.