En AP8, nous avons fusionné des compteurs. Peut-on retrouver le même texte quand deux personnes écrivent chacune de leur côté ? Ce sujet prolonge AP8 : vous construisez le cœur d’un petit éditeur répliqué et vous l’utilisez dans une interface web locale fournie. Il fait partie des sujets au choix d’AP9.
Le projet noté commence en semi-autonomie en AP9 et se termine à la maison. Cette première version comprend l’implémentation, les expériences guidées, puis vos propres tests et l’analyse des garanties. Les modalités de notation et l’échéance seront précisées avant le lancement en janvier ; les quatre paliers décrivent l’ordre des idées, pas un barème.
Ce parcours guidé construit un CRDT (conflict-free replicated data type) : une structure de données dont les copies, appelées répliques, se fusionnent dans n’importe quel ordre et finissent par coïncider. Le G-Counter d’AP8 en était un ; ici, chaque caractère garde une identité stable. Notre CRDT est « à base d’états », car les répliques échangent des snapshots complets, et il s’inspire de RGA (replicated growable array), un CRDT de séquence. Le parcours plus avancé de l’éditeur étudie les transformations opérationnelles (OT), avec son propre squelette et son protocole fourni. Ce sont deux approches distinctes, proposées comme des parcours alternatifs.
Téléchargez le squelette editeur-concurrent. Le projet fournit les deux GenServers, le parcours de la séquence, les tests et tout l’affichage. Vous n’avez besoin d’aucune connaissance de HTML, CSS ou JavaScript : ces fichiers sont déjà écrits. Vous complétez trois fonctions pures : insérer, supprimer et fusionner. Le README donne leurs contrats et les commandes de chaque palier. Le travail comprend aussi des traces à expliquer : trois fonctions courtes ne suffisent pas, à elles seules, à décrire le projet. Les slides 20 à 23 d’AP9 préparent ces étapes.
Ouvrir l’atelier
Depuis le terminal du dossier extrait, lancez :
mix deps.get
mix run --no-halt
La première commande télécharge les dépendances fournies avec l’interface. Ouvrez ensuite localhost:4009 dans votre navigateur. Les deux éditeurs s’affichent dès le départ ; les commandes qui utilisent une fonction encore incomplète vous indiquent ce qu’il reste à écrire. Le README explique comment arrêter puis relancer l’application après vos modifications. Aucun serveur supplémentaire n’est à configurer.
Une position ne désigne pas toujours le même caractère
Alice et Bob partent d’une copie commune de ab. Tous deux insèrent quelque
chose à l’indice 1, entre a et b : Alice écrit X, Bob écrit Y.
Ils voient respectivement aXb et aYb. À quel élément du document leurs
insertions font-elles référence ?
Nous donnons à chaque élément un identifiant stable et nous conservons
l’identifiant de son prédécesseur au moment de l’insertion. Ainsi, X et Y
restent tous deux attachés au même a, même si les positions affichées changent.
Les indices servent à exprimer une commande locale ; les identifiants font
partie de l’état qui sera fusionné.
Lire la représentation fournie
Un document contient une map entries et un ensemble deleted. Voici son
état après qu’Alice a écrit le texte commun ab :
%{
  entries: %{
    {1, :alice} => %{after: :root, value: "a"},
    {2, :alice} => %{after: {1, :alice}, value: "b"}
  },
  deleted: MapSet.new()
}
L’identifiant contient un compteur logique et l’identité de l’écrivain.
next_id/2, déjà fourni, choisit un compteur supérieur à tous ceux connus dans
le document, y compris ceux reçus d’autres répliques ou masqués. Ainsi, à partir
de ab, Alice crée {3, :alice} et Bob crée {3, :bob}.
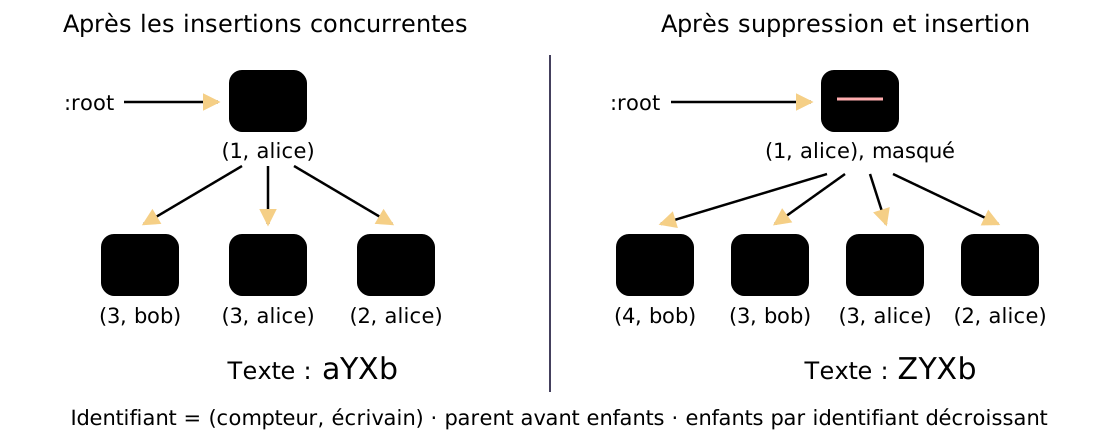
Les relations after forment un arbre enraciné en :root. Le parcours fourni
visite chaque parent avant ses enfants et classe les enfants d’un même parent
par identifiant décroissant : d’abord le compteur, puis l’atome en cas d’égalité.
Dans notre exemple, {3, :bob} précède {3, :alice}, puis vient {2, :alice}.
Le texte fusionné est donc aYXb. Ce choix est une règle commune aux répliques ;
il ne mesure pas qui a tapé en premier dans le monde réel.
Chaque insertion accepte une chaîne contenant une unité de String.graphemes/1.
Les positions du TP indexent les entrées visibles. Cela suffit pour nos essais,
mais ne constitue pas toute l’ergonomie d’un éditeur Unicode.
Palier 1 : écrire et masquer localement
Complétez Document.insert/4 et Document.delete/2 dans
lib/concurrent_editor/document.ex. Les helpers fournis traduisent un indice
en identifiant et vérifient le caractère. L’insertion ajoute une entrée dont
le parent est l’élément visible précédent, ou :root en position 0.
Une insertion valide renvoie {:ok, document} ; une position ou un caractère
invalide renvoie l’erreur décrite dans le README.
Supprimer ajoute l’identifiant visé à deleted. L’entrée reste présente : elle
peut encore servir de parent à un caractère connu d’une autre réplique.
Ce marqueur de suppression est appelé une tombstone. Le parcours continue
à visiter ses descendants, mais n’affiche plus sa valeur.
Prédisez le texte obtenu en insérant successivement a, b, puis X entre
les deux. Supprimez ensuite a. Quelles entrées doivent rester dans la map ?
Les tests du premier palier couvrent aussi les positions invalides et la chaîne
vide ; vous pouvez les lancer avant d’avoir écrit la fusion.
mix test --only palier_1Pour poursuivre, vous devez savoir expliquer pourquoi supprimer a dans
aXb affiche Xb tout en conservant trois entrées dans la structure.
Palier 2 : fusionner les connaissances
Complétez Document.merge/2. Pour les états valides de ce TP, un identifiant
ne désigne qu’une seule entrée immuable. Fusionner consiste donc à réunir les
entrées et les marqueurs de suppression des deux documents. Le résultat est
directement un document.
Vérifiez les trois lois déjà rencontrées en AP8 : l’ordre des deux arguments, le regroupement de trois fusions et la répétition d’un état ne changent pas le résultat. Ajoutez un ancien snapshot après une suppression : peut-il faire réapparaître la lettre ? Pourquoi ?
Ces lois portent sur les états compatibles du protocole. Si deux écrivains réutilisent le même identifiant pour des valeurs différentes, le contrat est violé et une simple union de maps ne résout plus le souci. Nous gardons un seul écrivain par identité, sans remise à zéro au milieu d’une expérience.
mix test --include palier_2Palier 3 : écrire dans les deux copies
Les processus nommés :alice et :bob démarrent avec l’application. Leur code
est fourni ; il appelle vos fonctions et conserve le document. La page locale
montre une zone de texte pour chacune des deux personnes. Le code fourni
traduit une saisie validée en insertions et suppressions Elixir ; il ne remplace
pas votre algorithme de fusion.
Commencez par écrire ab une seule fois chez Alice. Cliquez sur « Valider la
saisie », puis « Capturer un état ». Envoyez cet état à Bob avec le bouton du
message. Écrire séparément deux fois ab créerait quatre entrées distinctes !
Retenez ensuite les échanges. Changez le texte en aXb chez Alice et en aYb
chez Bob, puis validez les deux saisies. Chaque validation ne modifie que la
copie concernée. Capturez les deux états, puis envoyez chacun à l’autre personne.
Les deux textes doivent devenir aYXb. Les messages capturés restent figés :
rejouez-les dans un autre ordre, puis renvoyez l’ancien état ab.
Les échanges sont désactivés tant qu’une saisie n’est pas validée ou annulée. Cela évite qu’un message efface un brouillon. Ouvrez les détails de chaque copie pour observer ses identifiants et ses ancres. IEx reste disponible si vous préférez inspecter directement les documents ; il n’est pas requis pour cette expérience.
Pour une seconde expérience, partez de ces deux copies synchronisées. Alice
efface le premier a pendant que Bob insère Z juste après a. Validez chez
les deux personnes et transmettez leurs nouveaux snapshots. Après
fusion, les deux copies donnent ZYXb. Le a masqué reste l’ancre de Z
et des autres descendants. Le schéma représente ce lien : l’élément disparaît
de l’affichage, pas de la structure.
mix test --include palier_2 --include palier_3Cette commande inclut tous les tests fournis. mix test seul laisse les
derniers paliers exclus. Le README précise comment reprendre les mêmes
expériences dans IEx, au besoin.
Palier 4 : construire votre vérification
Inventez deux scénarios à partir d’un texte commun. Incluez une ancienne copie reçue après une suppression et une phase où les copies écrivent sans échange. Prédisez le texte final et dessinez les ancres avant d’exécuter les commandes. Une fois toutes les mises à jour reçues, comparez les états complets : deux textes égaux peuvent masquer des connaissances différentes.
Ajoutez ces scénarios aux tests du projet et expliquez ce que chacun protège. Les tests du cœur pur n’ont besoin ni du navigateur ni des GenServers. Le README indique le fichier à créer et les tags qui activent les tests.
Conservez COMPTE-RENDU.md avec les commandes de vérification, vos traces
prédites puis observées, la justification des trois lois de fusion et une
limite constatée. Reliez les lois aux unions de maps et d’ensembles, sous
l’hypothèse d’identifiants compatibles. Quelques tests réussis illustrent
ces lois ; ils ne les prouvent pas pour tous les états possibles.
Pour observer une limite, vous pouvez masquer tout le texte, réinsérer une lettre, puis comparer la longueur affichée aux tailles des deux collections. Le nettoyage des marqueurs nécessiterait de connaître les états encore en circulation : une décision locale ne suffit pas.
Ces quatre paliers forment le parcours guidé de cette version. En fin de séance, notez ce qui fonctionne et le prochain essai pour la poursuite à la maison. Une troisième réplique ou des traces générées sont des prolongements ; ils ne demandent pas de modifier l’interface fournie.
Jusqu’où va cette expérience ?
Nous utilisons une adaptation pédagogique à base d’états, inspirée de RGA. Le lien entre identifiants, arbre et parcours est décrit dans la figure 5 de Kleppmann et al., Interleaving anomalies in collaborative text editors. L’article montre aussi pourquoi converger ne suffit pas à garantir un ordre agréable dans tous les scénarios d’édition. Nous ne prouvons pas ici une préservation générale de l’intention des utilisateurs.
La coupure est simulée en retenant des snapshots entre deux processus de la même VM. Les états restent en mémoire et les marqueurs de suppression s’accumulent. Reprise après panne, nettoyage de ces marqueurs, curseurs, annulation et interface d’édition complète seraient d’autres projets. Les mêmes mises à jour doivent finir par atteindre les deux répliques pour qu’elles convergent.
Quand un bout de syntaxe Elixir vous manque, le poly la reprend : processus et GenServer aux chapitres 9 et 10, réplication au chapitre 11. Pour toute question sur le sujet ou le point de départ, vous pouvez me contacter par email, comme pour les autres séances.
Pour les curieux : le fascicule
Un petit fascicule d’approfondissement accompagne ce sujet : les idées derrière le projet, leur histoire, ce qu’elles deviennent dans les systèmes réels et quoi lire ensuite. C’est un cadeau de fin de cours ; rien n’y est à rendre.