Comment le réseau d’AP5 calcule-t-il la dérivée de sa perte par rapport à tous
ses paramètres ? En AP5, grad faisait ce travail pour nous. Dans ce prototype
AP9, vous écrivez vous-même un petit moteur de différentiation automatique,
c-à-d. un programme qui calcule les dérivées d’un calcul en suivant sa
structure, sans formule symbolique ni approximation, puis vous l’utilisez
pour apprendre XOR. Les graphes d’AP2–AP4 rencontrent ici le gradient d’AP5.
Télécharger le squelette Micrograd
Le projet commence en cours et se poursuit à la maison. Le README de l’archive donne le parcours complet : notions, représentations, fonctions, tests et expériences. Les modalités du projet noté seront annoncées avant le lancement ; les étapes ne sont pas un barème et les prolongements ne constituent pas un second projet.
Un graphe, des valeurs et des dérivées
Le moteur travaille sur des nombres ordinaires, sans tenseur. Chaque opération ajoute un nœud à un graphe de calcul : le nœud garde sa valeur, l’opération qui l’a produite et les identifiants de ses arguments. Une multiplication conserve ainsi les identifiants de ses deux arguments, même s’ils désignent la même valeur. Si une valeur est réutilisée, les contributions à sa dérivée doivent être additionnées. L’ordre de parcours fourni garantit que toutes ces contributions sont reçues avant de poursuivre.
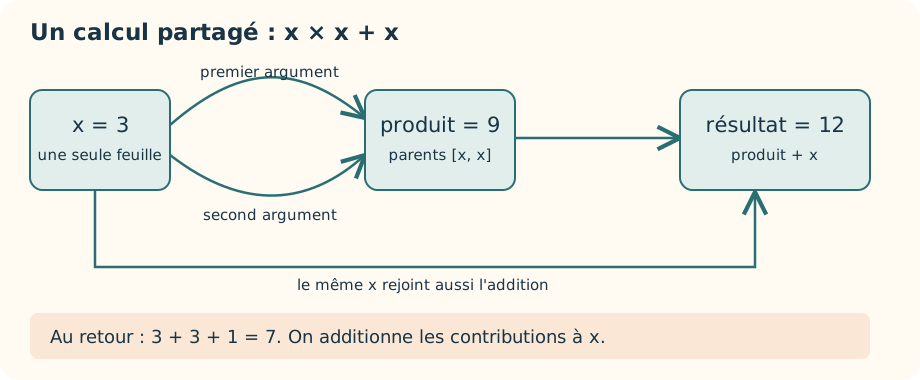
Lisons le schéma. Pour x*x + x, la valeur x alimente deux fois le produit
et une fois l’addition. En x = 3, le produit renvoie deux contributions de
3 et l’addition une contribution de 1 : la dérivée totale vaut 7, ce que la
formule 2x + 1 confirme. Pouvez-vous deviner ce que répondrait un moteur
qui transformerait la liste des parents [x, x] en ensemble ? Il perdrait
l’une des deux contributions du produit et répondrait 4 au lieu de 7.
Deux notions suffisent pour tout le projet. La dérivée locale d’une
opération est sa dérivée par rapport à chacun de ses arguments, prise
isolément : pour un produit a * b, c’est b pour a et a pour b. La
propagation inverse, ou rétropropagation, part du résultat, dont la
dérivée par rapport à lui-même vaut 1, et remonte vers les feuilles en
multipliant la dérivée reçue par la dérivée locale de chaque argument, puis
en additionnant les chemins qui se rejoignent : c’est la règle de la chaîne,
appliquée nœud par nœud.
Le graphe reste immuable. Une map distincte contient les gradients ; chaque
appel repart d’une map neuve, sans variable globale ni dictionnaire de
processus. Les dérivées locales du produit et de tanh, puis la propagation
inverse, sont vos trois fonctions à compléter, dans
lib/micrograd_lab/backward.ex.
Démarrer et avancer
mix compile
mix test --only provided
mix run -e 'IO.inspect(MicrogradLab.Demo.forward())'
Ces commandes fonctionnent avant les trous : les quatre tests du code fourni
passent, et le dernier appel affiche notamment value: 12.0, c-à-d. x*x + x
en x = 3, calculé sans aucune dérivée. Poursuivez avec les dérivées locales
(mix test --only local), la propagation (mix test --exclude training),
puis le réseau (mix test). Le README introduit chaque règle au moment où
vous en avez besoin, avec les fonctions Elixir utiles (Enum.reduce/3,
Enum.zip/2, Map.update/4).
Le graphe, son parcours, le petit réseau 2–4–1 (deux entrées, quatre neurones
cachés, une sortie, soit 17 paramètres), la boucle d’apprentissage et le
dessin sont fournis. Elixir suffit, sans bibliothèque numérique ni GPU. Vous
n’avez aucun code web à écrire. Le dernier essai exporte une courbe CSV et une
image SVG avec mix run -e 'MicrogradLab.Demo.run()'.
Une vérification indépendante accompagne votre moteur : les différences
finies approchent une dérivée par (f(x + h) - f(x - h)) / (2h), avec deux
évaluations ordinaires et sans votre algorithme. Le test du réseau compare
ainsi vos 17 dérivées à cette approximation. Pourquoi un h extrêmement
petit ne donne-t-il pas forcément une meilleure mesure ? La réponse tient à
la précision des flottants ; gardez-la pour le compte rendu.
Ce que vous devez pouvoir expliquer
Conservez un exemple de valeur utilisée plusieurs fois, une comparaison
avec les différences finies et une expérience sur l’apprentissage (le taux,
le nombre de pas, ou les gradients de tanh sur de grandes valeurs), en ne
changeant qu’un réglage à la fois. Les quatre points XOR sont les données
apprises ; leur classification correcte ne mesure pas la généralisation à des
observations nouvelles, et le fond du dessin montre une prédiction du modèle,
pas une vérité de référence.
Votre projet conserve le code, vos tests personnels, une recette de lancement
et un compte rendu qui explique un graphe partagé, la vérification numérique
et l’expérience choisie. Le dossier out/ est ignoré par Git : copiez les CSV
et SVG retenus dans rendu/. En quittant la séance, notez le prochain point
de passage.
Le parcours topologique, une nouvelle opération ou les nombres duaux offrent des prolongements après le socle. L’idée s’inspire de micrograd de Karpathy, avec un état explicite adapté à Elixir.
Pour toute question, vous pouvez me contacter par email : aurelien.noce@minesparis.psl.eu.
Pour les curieux : le fascicule
Un petit fascicule d’approfondissement accompagne ce sujet : les idées derrière le projet, leur histoire, ce qu’elles deviennent dans les systèmes réels et quoi lire ensuite. C’est un cadeau de fin de cours ; rien n’y est à rendre.